Power Automateのアクションが「つながらない」を解決する、アルゴリズム・アクション・データの3層思考法

はじめに:Power Automateで誰もがぶつかる壁

Power Automateを勉強していると、多くの人が次のような疑問にぶつかります。

  • 次にどのアクションを置けばいいのか分からない
  • このアクションと次のアクションをどうつなげればいいのか分からない
  • 動的なコンテンツがたくさん出てくるけれど、どれを選べばいいのか分からない
  • とりあえずアクションを並べて、テスト実行してエラーを直す……というやり方になってしまう

こうした行き詰まりを整理するために有効なのが、フローを「アルゴリズム・アクション・データ」という3つのレイヤーに分けて考える方法です。本記事では、この考え方を軸に、Power Automateを設計・学習するときの「型」を整理します。

難しさの正体は「アクションの使い方」だけではない

Power Automateには、SharePointからの項目取得・更新、Teamsへのメッセージ投稿、条件分岐、繰り返し処理、データ加工など非常に多くのアクションがあります。しかし、それぞれの使い方を個別に覚えても、

「結局、このアクションと次のアクションをどうつなげればいいの?」

という問題は残ります。ここで重要なのは、Power Automateを単なる「アクションの組み合わせ」ではなく、処理の流れ+データの流れとして捉えることです。

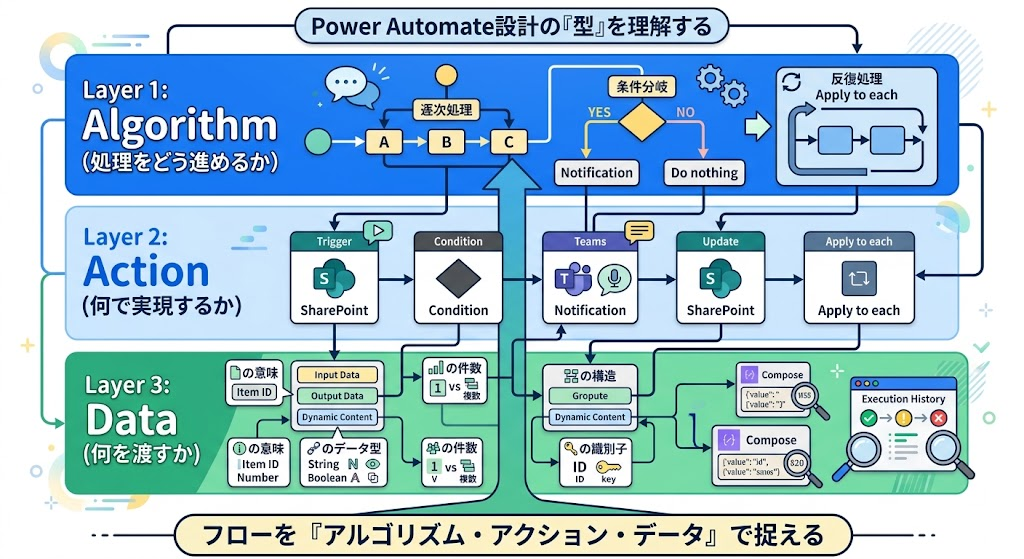
Power Automateを構成する3つのレイヤー

フローは次の3層構造で捉えると整理しやすくなります。

レイヤー 問い 役割
① アルゴリズム 処理をどう進めるか 業務ロジックの設計
② アクション その処理を何で実現するか Power Automate上の実装
③ データ 各アクションに何を渡すか 入出力の設計

この3つを混ぜずに考えることが、フロー設計を理解するうえでの出発点になります。

第1層:アルゴリズム

まず「この業務を、どのような論理で処理するのか」を、Power Automateの画面に置き換える前に考えます。

例:「SharePointに登録された案件について、未処理ならTeamsに通知し、通知済みに更新する」

案件が登録・更新される
        ↓
通知状態を確認する
        ↓
未処理か?
   ┌────┴────┐
 YES          NO
  ↓            ↓
通知する      何もしない
  ↓
通知済みに更新

アルゴリズムには次の基本的な「型」があります。

  • 逐次処理:処理を上から順に実行する(A → B → C)
  • 条件分岐:条件によって処理内容そのものが変わる(「最終アクションが複数あるから分岐」ではなく「処理内容が変わるから分岐」と捉えるのがポイント)
  • 反復処理:複数のデータに同じ処理を繰り返す(Apply to eachの本質)
  • 並列処理:互いに依存しない処理を並行して実行する(例:Teams通知とメール送信を同時に行う)

学習初期は、まず逐次処理とデータの受け渡しの理解を優先するとよいでしょう。

第2層:アクション

アルゴリズムが決まったら、「この処理をPower Automateの何で実現するのか」を考えます。

【アルゴリズム】          【アクション】
未処理なら通知する   →   トリガー → 条件 → Teamsにメッセージを投稿
        ↓                        ↓
通知済みにする       →   SharePoint項目を更新

アクションは、アルゴリズムをPower Automate上で実装するための「部品」と捉えると分かりやすくなります。

第3層:データ(最も難しいレイヤー)

「SharePoint項目を更新」のようなアクションを置くと、サイトのアドレス・リスト名・ID・各列の値などの入力を求められます。ここで「IDには何を入れればいいの?」という疑問が生じます。これがデータ設計の問題です。

「アクションをつなぐ」とは、データをつなぐこと

画面上ではアクションを縦に並べてつなぎますが、本質的にはアクションAが出力したデータを、アクションBが必要とする入力に渡しているだけです。

アクションA
   │ 出力データ
   ↓
アクションB
   │ 出力データ
   ↓
アクションC

「動的なコンテンツ」は、前段のアクションが出力したデータを後段のアクションへ渡すための候補にすぎません。表示されたからといって、そのまま入れてよいとは限らない点に注意が必要です。

アクションを接続するときに確認する5つの観点

同じような名前のデータをなんとなく選ぶのではなく、次の5点を確認すると整理しやすくなります。

  1. 意味:例えば「ID」と一口に言っても、SharePoint項目のID・ユーザーID・メッセージID・ファイルIDなど、同名でも意味が異なる場合がある
  2. データ型:文字列/数値/真偽値/日付/配列/オブジェクトなど、後段が期待する型と合っているか
  3. 件数:1件なのか複数件なのか。複数件を1件ずつ処理するなら反復処理が必要になる
  4. 構造:単純な値(文字列)なのか、複数のプロパティを持つオブジェクトなのか
  5. 識別子:どのデータを指しているかを特定する情報は何か(例:SharePointの項目更新でIDが必要なのは、更新対象を一意に特定するため)

設計のコツ:「後ろから考える」逆算アプローチ

最終アクションから逆算して考えると、必要なデータが明確になります。

最終アクション:SharePoint項目を更新
        ↓
何が必要? → ID/案件番号/通知状態…
        ↓
それぞれどこにある?
        ↓
トリガーにある? 別の取得アクションが必要? 検索が必要?

最終アクションが要求するデータが前段に存在しない場合は、中間アクションを追加します。中間アクションの役割は主に次の4つに整理できます。

  • 取得:必要なデータを取得する(例:SharePointから項目を取得)
  • 検索・絞り込み:条件に一致するデータを探す
  • 変換:文字列・日付・配列などデータの形を変える
  • 分解:複数件のデータを1件ずつ処理できる形にする

こう考えると、「何となくアクションを追加する」のではなく、「最終アクションが必要とするデータを作るためにこのアクションが必要」と論理的に説明できるようになります。

学習の型:やりたいことからテストまでの流れ

  1. やりたいことを決める
  2. 処理のアルゴリズムを考える(逐次/分岐/反復/並列)
  3. アルゴリズムをアクションに置き換える
  4. 最終的に実行したいアクションを確認する
  5. 最終アクションの入力欄を見る
  6. 各入力欄が要求するデータを確認する
  7. そのデータが前段にあるか探す
    • あれば:動的なコンテンツで接続
    • なければ:取得・検索・変換・分解のいずれかで作る
  8. 各アクションをデータで接続する
  9. Composeや実行履歴で確認する
  10. テスト実行する

Composeは「データの中身を見る」ための道具

設計段階では「この動的なコンテンツには何が入っているんだろう?」という疑問がよく出てきます。そこで役立つのがComposeです。前のアクションの出力をComposeに渡して実行すれば、実際の値を確認できます。さらに実行履歴を見れば、入力・処理・出力の流れを追うこともできます。Composeと実行履歴は、いわばデータの流れを観察するための道具です。

「動的なコンテンツを選ぶ」ことが目的ではない

意識が「この欄にはどの動的なコンテンツを入れればいい?」に向きがちですが、本当に考えるべきは「この入力欄が要求しているデータは何か」です。

要求されているデータ
        ↓
そのデータを持っているアクション
        ↓
動的なコンテンツ

動的なコンテンツから逆に考えるのではなく、要求されているデータから考えることがポイントです。

まとめ:フローは「線」ではなく「データ」で見る

Power Automateの画面上ではアクション同士が「線」でつながっているように見えますが、頭の中では「何のデータが、どこからどこへ移動しているのか」を追う方が本質的です。

レイヤー 問い 具体例
① アルゴリズム どう処理する? 逐次・分岐・反復・並列
② アクション 何を使って実現する? 取得・検索・変換・条件・通知・更新
③ データ 何を渡す? 意味・型・件数・構造・識別子

Power Automateの「アクションをつなぐ」とは、画面上の箱を線でつなぐことではありません。前のアクションが出力したデータを、次のアクションが要求する入力として渡すことです。そして、そのデータの受け渡しを考えるときには「意味・型・件数・構造・識別子」の5つを見る。

この視点を持てるようになると、Power Automateのフローは「なんとなくアクションを並べるもの」から、「アルゴリズムとデータの流れを設計して組み立てるもの」として見えてくるはずです。
【Power Query】List.FirstN+List.Sumの累計処理がO(N²)で重くなる理由をBig O記法から解説

はじめに

Power Query(M言語)で累計列を作るとき、List.FirstN で先頭から現在行までを切り出し、List.Sum で合計する——という書き方は直感的でわかりやすい一方、行数が増えると急激に処理が重くなることがあります。

この記事では、その原因である Big O(ビッグオー)記法 の考え方と、Power Queryでの改善アプローチを整理します。Big Oは直感に反する部分が多く、初めて学ぶときに誤解しやすいポイントがいくつかあるため、随所に「間違えやすいポイント」として補足しています。

Big O記法とは何か

Big O記法は、アルゴリズムの計算効率を表す標準的な指標です。ポイントは以下の1文に尽きます。

Big O記法は「今何秒かかるか」を表すものではなく、「データ量 N が増えたとき、処理量がどのような割合で増えていくか」を表す記法です。

具体的な秒数ではなく、データが増えたときの増え方(オーダー) を見る指標だという点が重要です。

間違えやすいポイント 「O(N)なら処理は10,000回」「O(N²)なら処理は50,000,000回」のように、Big Oの記法そのものが具体的な回数を意味していると捉えてしまいがちです。実際には、Big Oは「Nが増えたときにどのくらいの勢いで処理量が増えるか」という増加の傾向(オーダー)を表すものであり、具体的な回数はあくまでイメージをつかむための目安です。

代表的なBig Oパターン

はじめてBig Oを学ぶ場合、まずは以下の3つを押さえるのがおすすめです。

記法 特徴
O(1) データ量に関わらずほぼ一定(配列の先頭を取得)
O(N) データ量に比例して増える(シンプルな1重ループ)
O(N²) データ量の2乗に比例して増える(2重ループに相当)

この3つを理解した後、次のふたつを追加すると理解が進みます。

記法 特徴
O(log N) 増えてもあまり遅くならない(二分探索)
O(N log N) 効率的なソート処理など

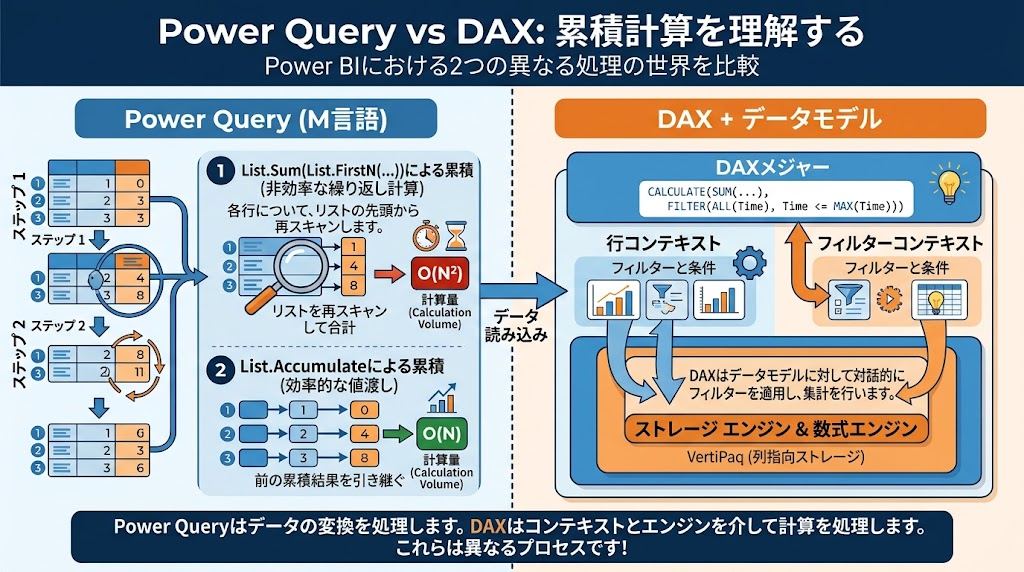
なぜ List.FirstN + List.Sum は O(N²) になるのか

「各行ごとに、先頭から現在行までをスライスして合計する」処理は、計算量の観点では2重ループに相当する構造になっています。

  • 外側:全 N 行を1行ずつ処理する → N回
  • 内側:その行までの要素を合計する
    • 1行目:1個を加算
    • 2行目:2個を加算
    • 3行目:3個を加算
    • N行目:N個を加算

このとき、List.FirstN は「先頭からi個を取り出す」処理、List.Sum は「そのi個を走査して合計する」処理であり、少なくとも List.Sum は行番号 i に比例するコストがかかります。

全体の処理規模は次の等差数列の合計になります。

1 + 2 + 3 + … + N = N(N+1) / 2

Big O記法では最も影響の大きい項(N²)だけを残し、係数や低次の項を無視するため、この処理は O(N²) と表記されます。

間違えやすいポイント 「内部で2重ループを行っている」という説明は、実装として本当に2重のfor文があるという意味ではありません。List.FirstNList.Sumという別々の関数呼び出しでも、計算量の観点で見ると2重ループに相当する規模の処理になっている、という意味です。実装の見た目と計算量の構造は分けて考える必要があります。

データ量による増加イメージ

O(N)(理想的な処理)と O(N²)(今回の処理)で、データ量に対する処理規模がどう変わるかを比較します。

データ件数 N O(N) の処理規模 O(N²) の処理規模(概算) 実際の累計対象数 N(N+1)/2
100 約100 約10,000 5,050
1,000 約1,000 約1,000,000 500,500
10,000 約10,000 約100,000,000 50,005,000
100,000 約100,000 約10,000,000,000 5,000,050,000

データが10倍になると、O(N) は約10倍で済みますが、O(N²) は約100倍に増加します。これが数千〜数万行を超えたあたりで処理が急激に重くなる理由です。

間違えやすいポイント 上の表の「処理規模」は、対象要素へのアクセスや加算が発生する規模のイメージであり、CPUが実行する命令数そのものではありません。「O(N²)だから実際に1億回CPUが処理する」という受け取り方は正確ではなく、あくまで増え方の分類を示す近似値として捉えるのが適切です。

O(N²)は「常に悪い処理」ではない

Big Oを学び始めると「O(N²)は悪い処理、O(N)は良い処理」と思いがちですが、これは正確ではありません。O(N²)が問題になるのは、データ量が大きくなったときに処理量が急増しやすいという性質であり、データ量が小さいうちは大きな問題にならないケースもあります。

例えば N=10 なら N²=100 で大きな影響はありませんが、N=1,000,000 なら N²=1,000,000,000,000 となり、桁が大きく変わります。また、係数の大きいO(N)(例:100N)と係数の小さいO(N²)を比べると、Nが小さい間はO(N²)の方が実測で速いケースもあります。Big Oは、データ量が大きくなったときの伸び方を比較するための指標であり、小さいデータでの優劣を保証するものではありません。

「Power QueryはO(N²)だから遅い」という一般化に注意

間違えやすいポイント 今回の話は「Power QueryそのものがO(N²)で遅い」という意味ではありません。正確には、今回採用したMコード(List.FirstN + List.Sum)のアルゴリズムがO(N²)的な計算量になっているという、実装依存の話です。Power Query(M言語)とDAX(Formula Engine / Storage Engine / VertiPaq)は別レイヤーの仕組みであり、混同しないよう整理しておくと理解がぶれません。

Power QueryでO(N)に近づける改善アプローチ

「前の行の累計値に、現在の行の値だけを足す(走査累計)」という考え方を、Power QueryのMコードで実現する際の現実的な方法を紹介します。

推奨パターン:List.Accumulate

List.Accumulate を使うと、リストを1回だけ走査しながら累計を構築できます。概念的な流れは以下の通りです。

初期値: [acc = {}, sum = 0]
各要素 x に対して:
    sum = sum + x
    acc = acc & {sum}
結果: acc が累計リスト

対象列をリスト化し、List.Accumulate で累計リストを作成してテーブルに再結合する形が一般的です。この方式であれば、リストを1回なぞるだけで済むためO(N)になります。

間違えやすいポイント 「1つ前の行の累計列を参照して足す」という書き方をそのままMで実装しようとすると、Power Queryの評価モデル上、各行で式が再評価される形になりやすく、結果的にO(N²)に近い挙動になることがあります。列同士を再帰的に参照する書き方よりも、値リストを取り出してList.Accumulateで処理する書き方の方が、計算量・実測の両面で安定して軽くなります。

前提:ソート順序

累計の意味を正しく保つには、日付やIDなど特定の順序でソートしてから累計を取る必要があります。順序が保証されていないと、アルゴリズム以前に累計の結果自体が意味をなさなくなります。ソート自体はO(N log N)ですが、O(N²)ほど急激には増加しないため、全体としては「O(N²) → O(N log N) + O(N)」という形に改善され、大幅に軽くなります。

改善後の処理時間について

O(N²)からO(N)に近いアルゴリズムへ改善できれば、データ量が増えたときの処理時間の増加を大幅に抑えられます。

間違えやすいポイント 「O(N)に改善すれば数万行でも必ず一瞬で終わる」とは限りません。Power Queryの実際の処理時間は、アルゴリズムの計算量だけでなく、列数・データソース・他の変換ステップ・ソート・結合・Table.Bufferの有無・クエリの折りたたみ・PCの性能など多くの要因に左右されます。計算量の改善は「処理時間の増加を抑える」ことを保証するものであり、絶対的な速さを保証するものではありません。

実測時の確認方法

Power BIやExcelのプレビュー自動更新がオンだと、UI側の再評価が加わり体感の処理時間がさらに重く感じられることがあります。アルゴリズムの差を正確に確認したい場合は、プレビュー自動更新をオフにした状態でクエリを単独実行して計測するのがおすすめです。

まとめ

  • Big O記法は「今何秒かかるか」ではなく「データ量が増えたときの処理量の増え方」を表す指標
  • List.FirstN + List.Sum による累計処理は、1+2+…+N = N(N+1)/2 の規模になり、Big Oでは O(N²) と分類される
  • O(N²)は「常に悪い処理」ではなく、「データ量が大きくなると急増しやすい」という性質を示すもの
  • 改善する場合は List.Accumulate による1回走査パターンが有効。行を再帰参照する実装ではO(N²)的な挙動が残るため注意
  • ソート順序の前提や、Power QueryとDAX/VertiPaqのレイヤーの違いを混同しないことも、正確な理解のポイント

需給管理表で学ぶPower Query vs DAX:行コンテキストと累計計算の違い

はじめに

需給管理表で「営業目標需要の累計」を作る際に使った、以下のMコードについて整理します。

List.Sum(
    List.FirstN(
        #"前のステップ"[営業目標需要],
        [インデックス] + 1
    )
)

このコードが「毎回先頭から計算し直している」という挙動を持つことをきっかけに、「これはPower BI(DAX)の行コンテキスト・フィルタコンテキスト・VertiPaq・Storage Engine・Formula Engineが解決しようとしている問題と同じなのか?」という疑問が生まれました。本記事では、この疑問に対する整理をまとめます。

Power BIの処理は「2段階」に分けて理解する

Power BIを理解する上でまず押さえておきたいのが、次の2段階です。

段階 役割
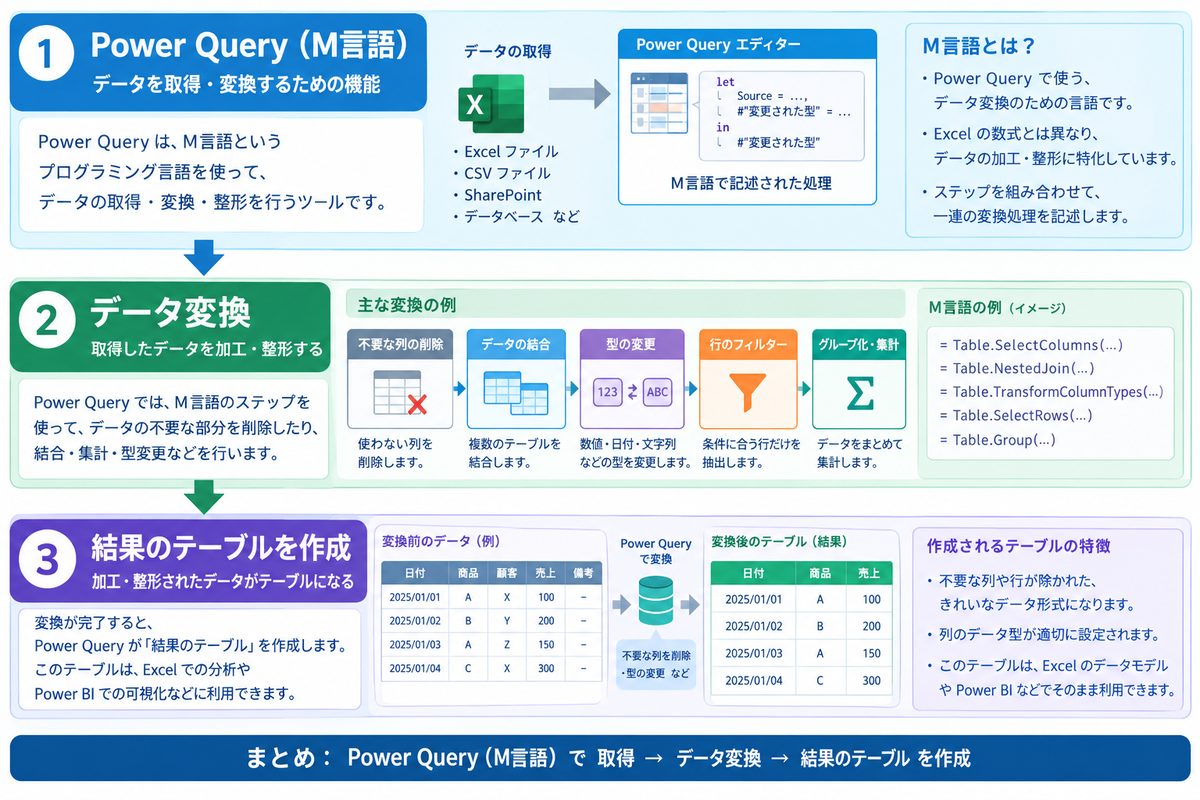
Power Query データを取り込み・加工し、テーブルを作る(M言語)
データモデル + DAX 取り込まれたデータをVertiPaqなどに格納し、集計・計算する

Power QueryとDAXは同じPower BIの中にありますが、「データを作る側」と「データを使う側」という役割の違いがあります。

今回のMコードは何をしているのか

元データの例(一部)は以下の通りです。

時期 集計対象 営業目標需要 商談ベース需要 在庫 納品予定
8月 砂糖01 0 0 0 0
9月 砂糖01 0 0 850 0
10月 砂糖01 200 100 0 0
11月 砂糖01 200 100 0 0
12月 砂糖01 200 100 0 1,000

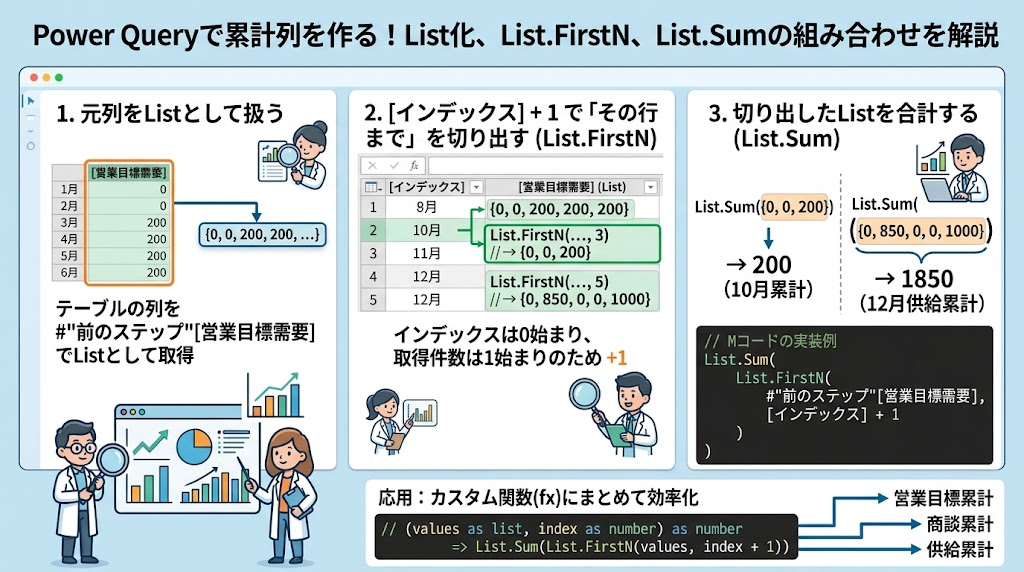
#"前のステップ"[営業目標需要] はテーブルの列をListとして取り出す処理で、例えば {0, 0, 200, 200, 200, 200} のようになります。

List.FirstN(そのList, [インデックス] + 1) は「現在の行までのデータを先頭から取り出す」処理です。10月(インデックス=2)であれば List.FirstN(リスト, 3){0, 0, 200} となり、List.Sum で200が得られます。

これを月ごとに整理すると次のようになります。

時期 取り出されるList SUM
8月 {0} 0
9月 {0, 0} 0
10月 {0, 0, 200} 200
11月 {0, 0, 200, 200} 400
12月 {0, 0, 200, 200, 200} 600

つまり、「前の行の累計」を保持して足しているのではなく、毎回リストの先頭から切り出して合計し直しているという点が、この処理の本質です。

DAXの「行コンテキスト」「フィルタコンテキスト」とは別物

DAXでは「今どの条件(例:2026年10月・砂糖01)で計算しているか」を扱うフィルタコンテキストという概念があります。グラフの横軸が「時期」であれば、各ポイントごとに異なるフィルター条件でDAXが再計算されます。

一方、Power Queryの each [営業目標需要] * 2 のような記述は「現在処理している行」を指しますが、これはあくまでM言語の行単位処理であり、DAXの行コンテキストとは別の概念です。

Power Queryのeach = DAXの行コンテキスト、と捉えるのは避けたほうがよいという点が今回の整理の重要なポイントです。

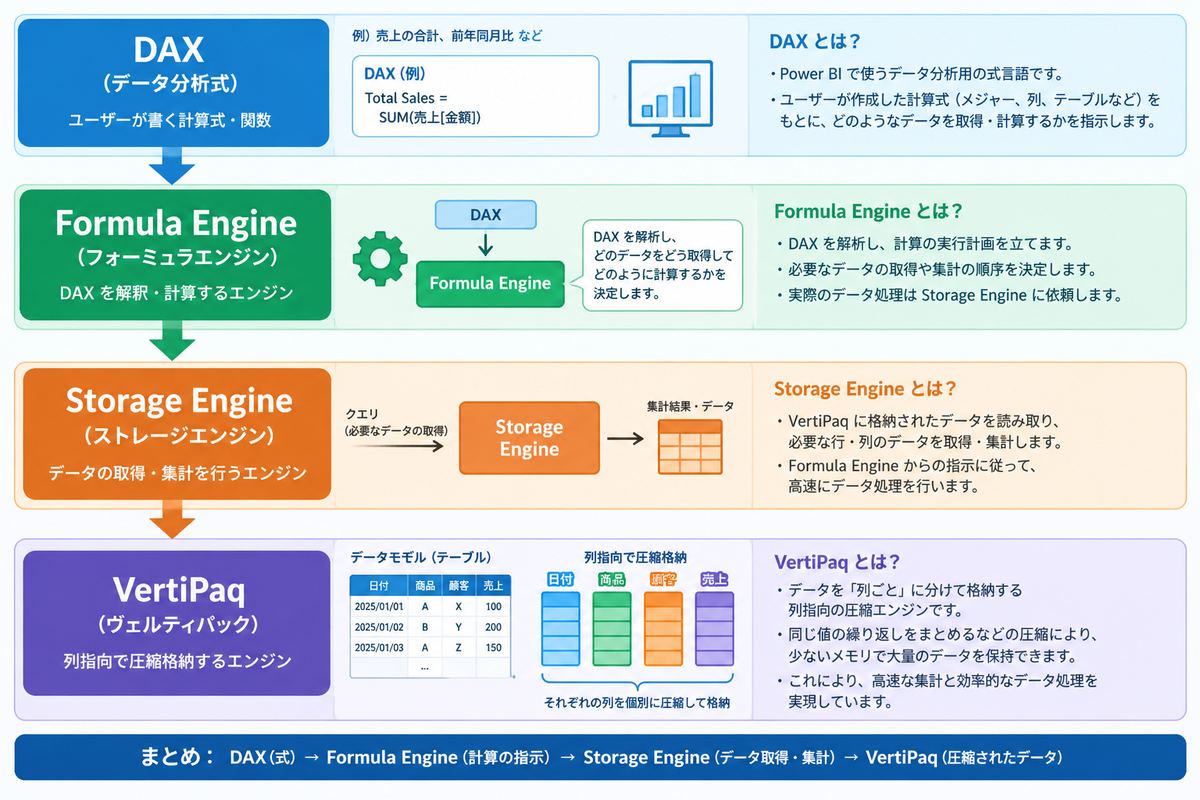
VertiPaq・Storage Engine・Formula Engineとの関係

DAXには以下のような内部処理の階層があります。

これに対し、Power Queryは

という別の世界です。今回のMコードについて「VertiPaqが賢く処理して、実際には毎回先頭から計算しないようにしてくれる」ということはありません。Power Queryの段階では、まだデータを変換している途中だからです。

全体像を図にすると以下の通りです。

┌────────────────────────────┐
│ Power BI                    │
│  ┌──────────────────────┐   │
│  │ Power Query           │   │
│  │ ・M言語                │   │
│  │ ・データの加工          │   │
│  │ ・テーブルを作る        │   │
│  └──────────┬───────────┘   │
│             ↓                │
│  ┌──────────────────────┐   │
│  │ データモデル            │   │
│  │ ・VertiPaq             │   │
│  │ ・データを格納          │   │
│  └──────────┬───────────┘   │
│             ↓                │
│  ┌──────────────────────┐   │
│  │ DAX                    │   │
│  │ ・行コンテキスト        │   │
│  │ ・フィルタコンテキスト   │   │
│  │ ・計算                 │   │
│  └──────────────────────┘   │
│             ↓                │
│         レポート表示          │
└────────────────────────────┘

より効率的な累計処理:List.Accumulate

今回のList.FirstN + List.Sumは「現在の行ごとに先頭からスライスして合計」するため、行数Nに対してO(N²)的な演算量になり得ます。数千行規模になると体感で処理が重くなることがあります。

これに対し、「前回までの結果を次に渡していく」という考え方に基づく List.Accumulate を使うと、累計をO(N)で作ることができます。List.Accumulateは「状態を次の計算に渡す」パターンそのものであり、累計をO(N)で作れる代表的な方法です。イメージは以下の通りです。

需要 前回までの累計 今回の累計
100 0 100
200 100 300
150 300 450
300 450 750

List.FirstN + List.Sum「過去をもう一度見る」方式と、List.Accumulate「過去の計算結果を引き継ぐ」方式の違いを整理すると次のようになります。

方式 考え方 計算量の目安
List.FirstN + List.Sum 毎回、先頭から再計算 O(N²)
List.Accumulate 等 前回の結果 + 現在の値 O(N)

実務では、数千行を超えるデータになると、List.FirstN + List.Sumの方式は体感で処理が重くなることがあります。大規模データで累計処理が重くなった場合は、以下のような選択肢が考えられます。

  • 「前の累計+現在の値」の形で計算する(状態引き継ぎ)
  • 集計粒度を落とす(月次→四半期など)
  • 必要列のみを残し、変換ステップを減らす
  • 累計計算自体をDAX側のMeasureに任せ、Power Queryは最小限の整形に留める

DAX側で累計を作る場合との対比

DAXで累計を作る場合は、たとえば以下のように「フィルタコンテキストを操作」することで実現します。

CALCULATE(
    SUM( ... ),
    FILTER( ALL( 時期 ), 時期 <= MAX( 時期 ) )
)

これは「行ごとの状態を引き継ぐ」のではなく、「コンテキストを書き換えて再集計する」という考え方であり、Power Queryの累計ロジック(先頭から再計算する、あるいは状態を引き継ぐ)とはアプローチが根本的に異なります。この対比を押さえておくと、Power QueryとDAXの役割の違いがより明確になります。

なお、「フィルタコンテキストはPower Queryには出てこない」とはいえ、Table.SelectRowsTable.Group のように「条件で絞る」「グループ内で集計する」処理自体はPower Queryでも可能です。ただし、これはDAXの「ビジュアルごとの動的フィルタ」とは性質が異なり、あくまで「テーブルそのものを書き換える前処理」と捉えるのが適切です。

また、「Power Queryにも内部的な実行エンジンがある」こと自体は事実ですが、これはDAXのVertiPaq・Storage Engine・Formula Engineとは別系統のものです。Power Queryの実行は「各ステップを順に適用してテーブルを作る」処理であり、VertiPaqの列指向圧縮・辞書エンコードのような仕組みとは直接関係しません。Power Queryはデータモデルへ読み込む前のETL段階であり、ここで計算した列は完成したテーブルとしてモデルに渡されます。VertiPaqによる最適化は、主にその後のDAX評価時に効いてくるものです。

まとめ

  • Power Query(M言語・データ加工)とDAX(行コンテキスト・フィルタコンテキスト・VertiPaq等)は、Power BI内の別の段階の処理であり、混同しないことが重要
  • 今回のList.FirstN + List.Sumは「毎回先頭から再計算」する方式であり、行コンテキストやVertiPaqが解決している問題とは別物
  • 大規模データでは、List.Accumulateなど「前回の結果を引き継ぐ」方式に切り替えることで計算量をO(N)に抑えられる
  • DAX側で累計を作る場合はフィルタコンテキストの操作によって実現するため、Power Queryの累計ロジックとはアプローチが異なる

Power Queryの「テーブル」と「リスト」は別物?よくある誤解と正しい理解を整理する

はじめに

Power Queryで需給管理表などのETL処理*を組んでいると、#"前のステップ"[列名] という記法が頻繁に登場します。この記事では、この記法が実際に何をしているのか、AIとの対話を通じて整理した「テーブル型」と「リスト型」の違いを、訂正の経緯も含めてまとめます。

「最初の理解のどこが甘く、どう修正されたか」を残すことで、同じ疑問を持つ人が同じ誤解を辿らずに済むようにするのが狙いです。

*ETL処理(Extract, Transform, Load)とは、社内の様々なシステムに分散しているデータを、1つの場所に集約して分析・活用できるようにするためのデータ加工・移送の一連のプロセスのことです。

そもそもの疑問

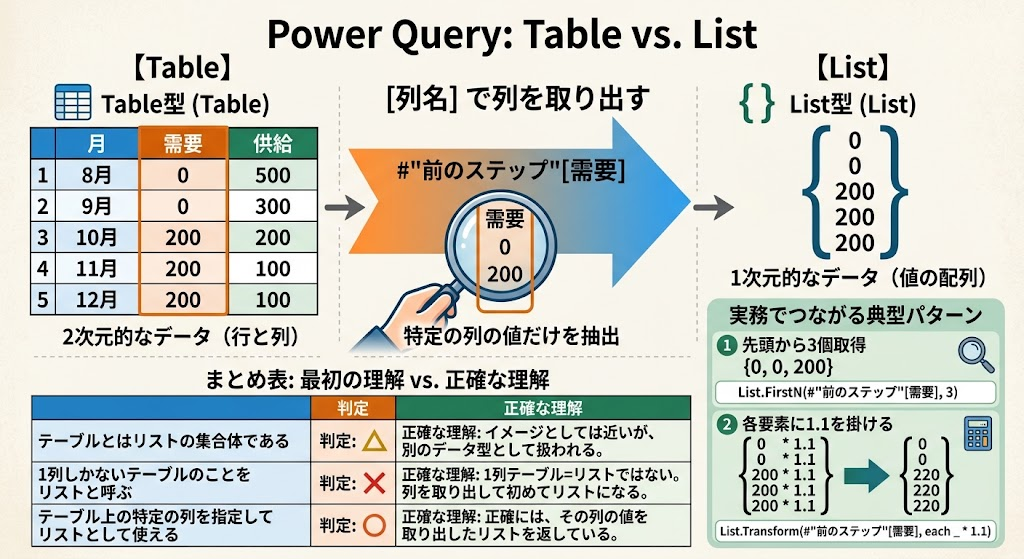
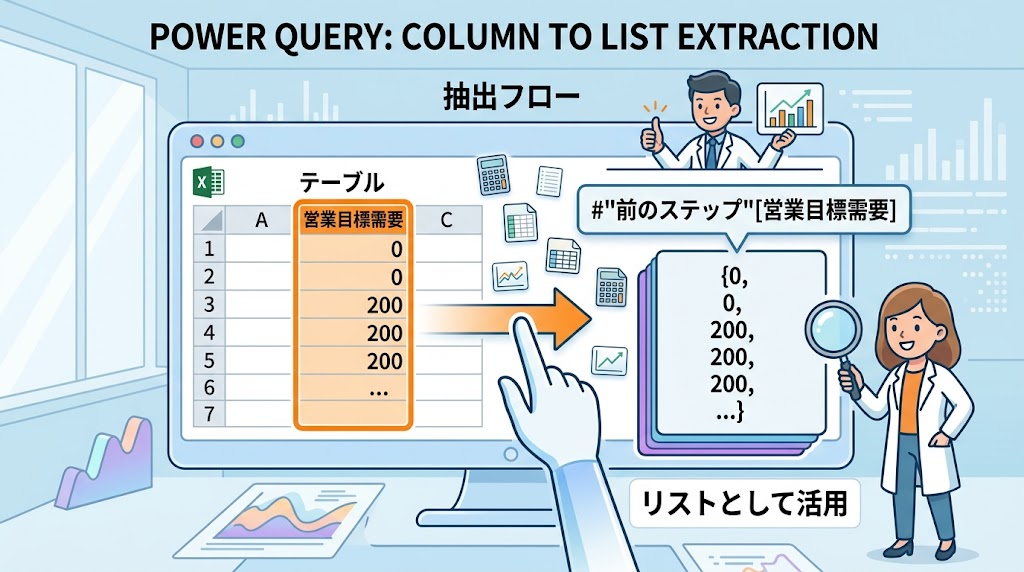
Power Queryでは、テーブルの1列を次のようにList化して扱えます。

#"前のステップ"[営業目標需要]

例えば、以下のようなテーブルがあったとします。

営業目標需要
8月 0
9月 0
10月 200
11月 200
12月 200

これに対して #"前のステップ"[営業目標需要] とすると、次のListが返ります。

{0, 0, 200, 200, 200}

この動作について、最初に立てた仮説は次の3つでした。

  1. テーブルとはリストの集合体である
  2. 1列しかないテーブルのことをリストと呼ぶ
  3. テーブルを分割してリストとして使える

以下、この3つの仮説をAIとの対話でどう修正していったかを整理します。

訂正ポイント①:「テーブル=リストの集合体」は不正確

最初の理解:テーブルとはリストの集合体である。

指摘・修正:概念として列ごとにListの塊があるとイメージするのは理解の助けにはなるが、Power Query上ではTable型とList型は明確に別のデータ型として扱われる。「テーブル=Listの集合体」と定義すると誤解を生む。

修正後の理解: - テーブル=行と列を持つ2次元的なデータ - リスト=値が順番に並んだ1次元的なデータ - 両者は別の型であり、列を取り出す操作を通じて初めてTable→Listの変換が起きる

訂正ポイント②:「1列しかないテーブル=リスト」は誤り

最初の理解:1列しかないテーブルのことがリストである。

指摘・修正:これは明確に誤り。1列しかないテーブルであっても、型としてはあくまでtable型であり、list型ではない。見た目が似ているだけで中身の型は異なる。

具体例

// 1列のテーブル(型:table)
#table(
    {"営業目標需要"},
    {
        {0},
        {0},
        {200},
        {200}
    }
)

// リスト(型:list)
{0, 0, 200, 200}

この違いが実務上効いてくるのは、使える関数が型によって異なる点です。

主な関数の例 意味
table Table.RowCount(table) テーブルの行数を取得
list List.Count(list) リストの要素数を取得

訂正ポイント③:「列名を除いたものがリスト」ではなく「列の値を取り出したもの」

最初の理解:テーブル上の特定の列を指定して、列名を除いたものがリストになる。

指摘・修正:概念的には近いが、より正確には「列名は“どの列を選ぶか”を指定するためのキーであり、返ってくるListには列名という概念自体が存在しない(値のみが並ぶ)」という理解が正しい。「列名を除く」という表現だと、あたかも列名込みの何かから列名を取り除く操作のように聞こえてしまうが、実際はそうではない。

修正後の理解

#"前のステップ"[営業目標需要]

は、

テーブルから「営業目標需要」という列を選び、その列に含まれる値を順番に並べたListを返す

という操作である。

訂正ポイント④:「テーブルを分割してリストとして使える」の言い換え

元の理解:テーブルを分割してリストとして使える(実用上は問題なし)。

より正確な言い換え:テーブルを物理的に分割しているわけではなく、同じテーブルを元に、列ごとにListを取り出して使っているイメージ。

具体例

let
    Source = #table(
        {"月", "営業目標需要", "供給"},
        {
            {"8月", 0,   500},
            {"9月", 0,   300},
            {"10月", 200, 200},
            {"11月", 200, 100}
        }
    ),
    需要List = Source[営業目標需要],  // {0, 0, 200, 200}
    供給List = Source[供給]           // {500, 300, 200, 100}
in
    需要List

全体まとめ表

最初の理解 判定 正確な理解
テーブルとはリストの集合体 イメージとしては近いが、Table型とList型は別のデータ型
1列しかないテーブルのことがリスト 1列テーブル=リストではない。列を取り出して初めてリストになる
テーブルを分割してリストとして使える テーブルの列を取り出してリストとして使える、が正確な表現

Table型とList型の3段階イメージ

【Table】
┌──────┬──────┐
│ 月   │ 需要 │
├──────┼──────┤
│ 8月  │ 0    │
│ 9月  │ 0    │
│ 10月 │ 200  │
└──────┴──────┘
        ↓ [需要] で列を取り出す
【List】
{0, 0, 200}
        ↓ List.Transform / List.FirstN などで処理
【新しいList】

実務でつながる典型パターン

この理解ができると、需給管理表などでよく使う以下の構文が自然につながります。

// 営業目標需要列をListとして取り出し、先頭3個を取得
List.FirstN(#"前のステップ"[営業目標需要], 3)

// 営業目標需要列をListとして取り出し、各要素に1.1を掛けた新しいListを作成
List.Transform(#"前のステップ"[営業目標需要], each _ * 1.1)
  • List.FirstN(テーブル[列名], n) … その列をListとして取り出し、先頭n個を取得する
  • List.Transform(テーブル[列名], each ...) … その列をListとして取り出し、各要素を加工した新しいListを作る

需要予測や在庫の累積計算(List.FirstN + List.Sum など)を組む際は、まずこの「列を取り出してListとして扱う」という基本操作を押さえておくと、後続のロジックが読みやすくなります。

【Power Query】List.FirstNの使い方完全ガイド〜件数指定・条件指定・停止挙動まで〜

はじめに

Power Query(M言語)の List.FirstN は、リストの先頭から指定した数(または条件)だけデータを取り出す関数です。

本記事では、基本構文から実務での活用パターンまでを整理し、さらにAIレビューによって指摘された補足事項・訂正ポイントも「訂正ポイント」として明示的に残す形で構成しています。


1. 基本構文

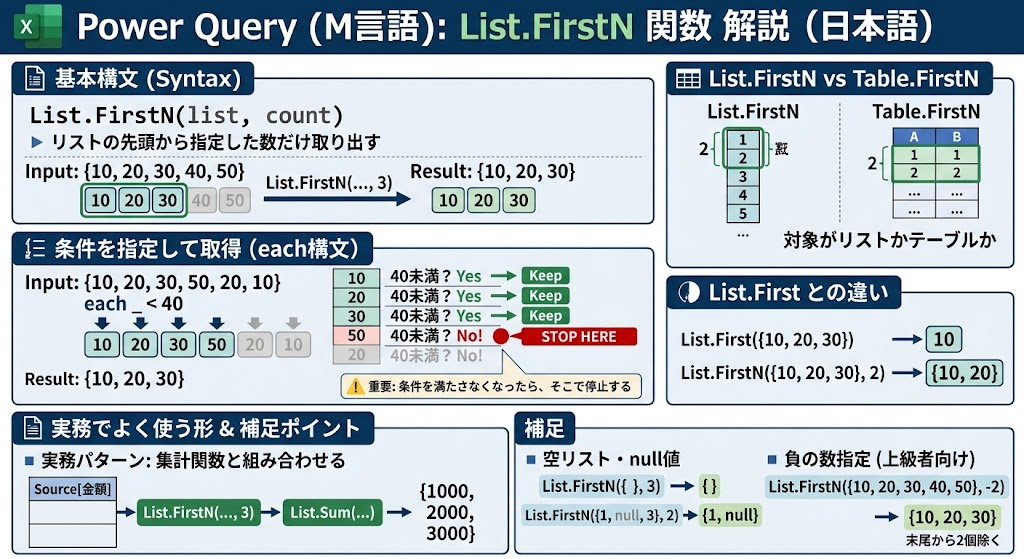
List.FirstN(list, count)
  • list:対象となるリスト
  • count:先頭から何個取り出すか

List.FirstN({10, 20, 30, 40, 50}, 3)
// 結果: {10, 20, 30}

元のリスト {10, 20, 30, 40, 50} から、先頭3件だけを残す処理です。Excelでいえば「上から3行だけ取得する」イメージに近く、「先頭からN件だけ残す」と覚えると分かりやすいです。


2. List.FirstN と Table.FirstN の違い

Power Queryには似た名前の関数として Table.FirstN もありますが、対象がリストかテーブルかで異なります。

関数 対象 結果
List.FirstN リスト List.FirstN({1,2,3,4,5}, 2) {1, 2}
Table.FirstN テーブル Table.FirstN(テーブル, 2) 先頭2行のテーブル

イメージ図:

List.FirstN
[1, 2, 3, 4, 5] → [1, 2]

Table.FirstN
┌────┬────┐        ┌────┬────┐
│ A  │ B  │        │ A  │ B  │
├────┼────┤   →    ├────┼────┤
│ 10 │ 20 │        │ 10 │ 20 │
│ 30 │ 40 │        │ 30 │ 40 │
│ 50 │ 60 │        └────┴────┘
└────┴────┘

3. 条件を指定して取得する(each構文)

List.FirstN の第2引数には、件数の代わりに判定関数(each式)を指定することもできます。

List.FirstN(
    {10, 20, 30, 40, 50},
    each _ < 40
)
// 結果: {10, 20, 30}

each _ < 40 は「値が40未満である間、先頭から取得する」という意味です。

⚠️ 重要:条件を満たさなくなったら、そこで停止する

List.FirstN(
    {10, 20, 30, 50, 20, 10},
    each _ < 40
)
// 結果: {10, 20, 30}

これは「40未満の数字を全部探して取得する」わけではありません。条件を満たす連続する要素だけを、先頭から条件を満たさなくなるまで取得する、という挙動です。

処理の流れ:

要素 判定 結果
10 40未満 → OK 取得
20 40未満 → OK 取得
30 40未満 → OK 取得
50 40未満でない → NG ここで終了
20 (評価されない) -
10 (評価されない) -

この「途中で条件を外すと、それ以降は評価せずに終了する」という点は、実務でハマりやすいポイントなので特に注意が必要です。


4. List.First との違い

関数 意味 結果
List.First 先頭1個を取得 List.First({10, 20, 30}) 10
List.FirstN 先頭N個を取得 List.FirstN({10, 20, 30}, 2) {10, 20}

5. 実務でよく使う形

ある列をリスト化すると、たとえば以下のようになります。

Source[金額]
// {1000, 2000, 3000, 4000, 5000}

ここから先頭3件を取得するには:

List.FirstN(Source[金額], 3)
// 結果: {1000, 2000, 3000}

6. 訂正・補足ポイント(AIレビューによる追加情報)

以下は、AIによるレビューで追加を推奨された補足事項です。元の解説自体に誤りはありませんでしたが、実務での応用力を高めるための追加情報として、あえて「補足」として明示的に残しています。

補足A:空リスト・null値の扱い

List.FirstN は、リストが空でもエラーにならず、空リスト {} を返します。

List.FirstN({}, 3)
// 結果: {}  (エラーにならない)

また、リスト内に null が含まれる場合、それは通常の「値」として扱われます。

List.FirstN({1, null, 3}, 2)
// 結果: {1, null}

補足B:負の数を指定した場合(上級者向け)

第2引数に負の数を指定すると、「末尾からN個を除いたリスト」が返ります(List.RemoveLastN と同じ挙動)。

List.FirstN({10, 20, 30, 40, 50}, -2)
// 結果: {10, 20, 30}
// 意味: 末尾2個(40, 50)を取り除いたリスト

※この挙動はやや特殊なため、基本の学習段階では「第2引数は正の数を使う」と理解しておき、上級者向けの補足として扱うのが安全です。

補足C:集計関数と組み合わせる実務パターン

List.FirstN の結果は、List.SumList.Average などの集計関数にそのまま渡せます。

たとえば「金額列の先頭3件の合計」を出す場合:

List.Sum( List.FirstN(Source[金額], 3) )

このように集計関数と組み合わせられる点が、Power Queryにおける List.FirstN の実務的な強みです。


7. まとめ

  • List.FirstN(list, count) は、リストの先頭からN件を取得する関数
  • 件数の代わりに each 条件 を指定すると、条件を満たす間だけ連続して取得(満たさなくなった時点で停止)
  • Table.FirstN はテーブル用、List.First は先頭1件のみを取得する関数であり、それぞれ役割が異なる
  • 空リスト・null・負の数など、基本パターン以外の挙動も押さえておくと実務で安心
  • List.Sum などの集計関数と組み合わせることで、「先頭N件の合計」のような実務処理に応用できる

「件数指定」と「条件指定」の2パターンを押さえておけば、List.FirstN は十分に使いこなせるようになります。

Power Queryで累計需要・累計供給から将来在庫を予測する方法

はじめに

需給管理表を作っていると、「営業目標需要」「商談ベース需要」「供給」の月次データはあっても、それを累計していつ在庫が足りなくなるかを可視化できていないケースは多いのではないでしょうか。

今回は、月次の需給データからPower Queryで累計列を作り、そこから「将来在庫見込」を算出するまでの考え方を整理します。

元データの構造

今回扱うのは、以下のような月次データです。

時期 集計対象 営業目標需要 商談ベース需要 在庫 納品予定 供給
2026/08 砂糖01 0 0 0 0 0
2026/09 砂糖01 0 0 850 0 850
2026/10 砂糖01 200 100 0 0 0
2026/11 砂糖01 200 100 0 0 0
2026/12 砂糖01 200 100 0 1,000 1,000
2027/01 砂糖01 200 100 0 0 0
2027/02 砂糖01 200 100 0 0 0
2027/03 砂糖01 200 100 0 1,000 1,000

ポイントは「供給」列で、次の式で定義されます。

供給 = 在庫 + 納品予定

在庫(現在手元にある数量)と納品予定(将来入ってくる数量)を合算したものが、その月の「供給可能数」になります。

累計を分けて考える

計算のコツは、「累計需要」と「累計供給」を別々に積み上げることです。それぞれ単純な足し上げですが、意味合いが異なります。

累計営業目標需要・累計商談ベース需要

各月の需要を、月が進むごとにそのまま加算していきます。

時期 営業目標需要 累計営業目標需要 商談ベース需要 累計商談ベース需要
2026/08 0 0 0 0
2026/09 0 0 0 0
2026/10 200 200 100 100
2026/11 200 400 100 200
2026/12 200 600 100 300
2027/01 200 800 100 400
2027/02 200 1,000 100 500
2027/03 200 1,200 100 600

累計供給

供給側も考え方は同じですが、ここが今回の設計で最も重要な部分です。9月に発生した在庫850台は、消費されない限りその後の月にもずっと引き継がれます。

時期 供給 累計供給
2026/08 0 0
2026/09 850 850
2026/10 0 850
2026/11 0 850
2026/12 1,000 1,850
2027/01 0 1,850
2027/02 0 1,850
2027/03 1,000 2,850

「9月だけ850、10月以降は0」としてしまうと、在庫を消費した後の残量が正しく計算できなくなります。累計供給と累計需要の差から将来在庫を出す、という考え方がここでのポイントです。

Power Queryでの実装:List化とList.FirstNの考え方

累計列は、Power Queryでは元の列をListとして取り出し、インデックスを使って「その行までの合計」を計算する方法で作成できます。

Listとして取り出す

Power Queryでは、テーブルの1列を #"前のステップ"[列名] の形でListとして扱えます。例えば「営業目標需要」列は次のようなListになります。

{0, 0, 200, 200, 200, 200, 200, 200}

Power Queryの「テーブル」と「リスト」は別物?よくある誤解と正しい理解を整理する - いろいろメモ

List.FirstNで「その行まで」を切り出す

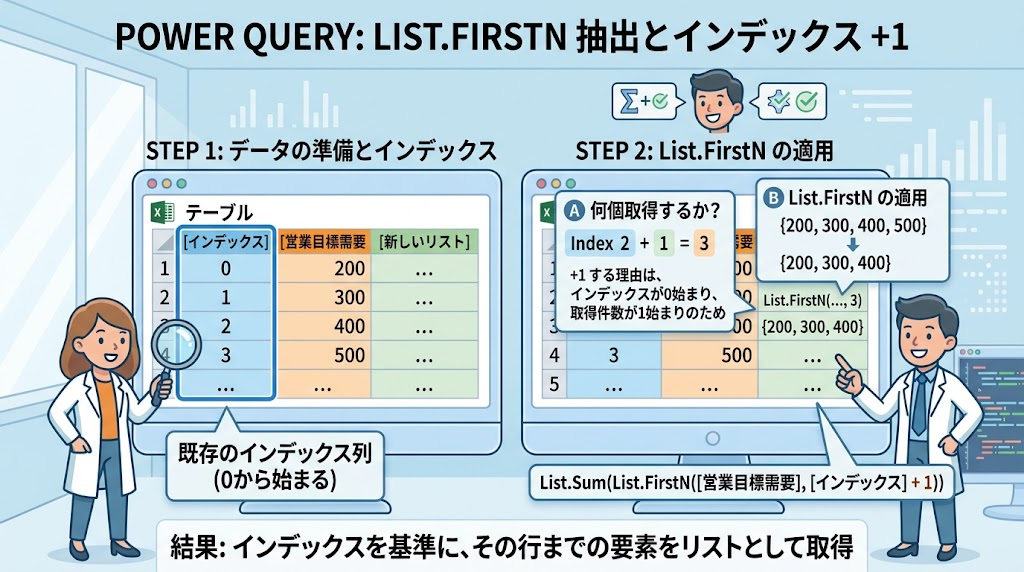
既存のインデックス列(0から始まる連番)を使い、List.FirstN でその行までの要素を取り出します。

List.FirstN({0, 0, 200, 200, 200}, 3)
// → {0, 0, 200}

List.FirstN の第2引数は「何個取得するか」なので、インデックスに対して +1 する必要がある点に注意してください(インデックスは0始まり*、取得件数は1始まりのため)。

*今回の累計計算だけなら1始まりにすると+1が不要になり直感的。ただし、M言語では位置指定が0始まりなので、0始まりを採用。

List.Sumと組み合わせる

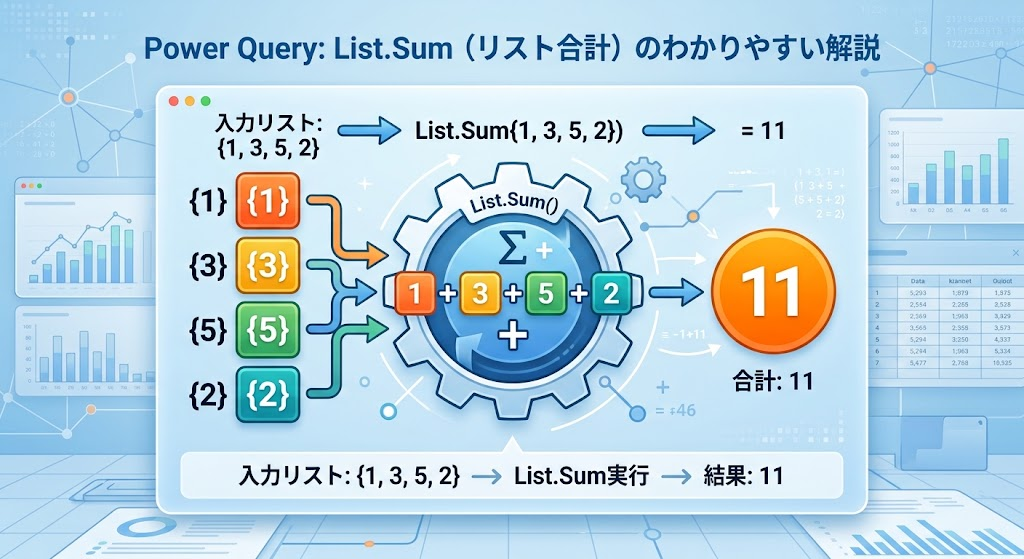
切り出したListを List.Sum で合計すれば、その行までの累計が得られます。

List.Sum(
    List.FirstN(
        #"前のステップ"[営業目標需要],
        [インデックス] + 1
    )
)

例えば10月(インデックス2)の場合、[インデックス] + 1 = 3 なので {0, 0, 200} が合計され、累計営業目標需要は 200 になります。

同じ式を供給列に適用すれば、累計供給も同じ考え方で計算できます。

List.Sum(
    List.FirstN(
        #"前のステップ"[供給],
        [インデックス] + 1
    )
)

12月(インデックス4)であれば {0, 850, 0, 0, 1000} の合計で 1,850 となります。

関数化するとさらに読みやすくなる

累計営業目標需要・累計商談ベース需要・累計供給の3列は、いずれも同じロジックの繰り返しです。そのため、次のようなカスタム関数を作っておくと見通しが良くなります。

// 累計を計算する関数(fx累計)
(values as list, index as number) as number =>
    List.Sum(
        List.FirstN(values, index + 1)
    )

これを使うと、各累計列は次のようにシンプルに書けます。

営業目標累計 = fx累計(#"前のステップ"[営業目標需要], [インデックス])
商談累計     = fx累計(#"前のステップ"[商談ベース需要], [インデックス])
供給累計     = fx累計(#"前のステップ"[供給], [インデックス])

なお、数か月〜数十か月程度の規模の需給表であれば、関数化は必須ではありません。最初は直接式を書いて仕組みを理解し、必要に応じて関数化する、という順序がおすすめです。

累計から将来在庫を算出する

累計列が揃えば、将来在庫の計算は非常にシンプルです。

営業目標ベース将来在庫 = 累計供給 − 累計営業目標需要
商談ベース将来在庫     = 累計供給 − 累計商談ベース需要
時期 累計供給 累計営業目標 営業目標ベース将来在庫 累計商談 商談ベース将来在庫
2026/08 0 0 0 0 0
2026/09 850 0 850 0 850
2026/10 850 200 650 100 750
2026/11 850 400 450 200 650
2026/12 1,850 600 1,250 300 1,550
2027/01 1,850 800 1,050 400 1,450
2027/02 1,850 1,000 850 500 1,350
2027/03 2,850 1,200 1,650 600 2,250

これで、営業目標ベース・商談ベースそれぞれの将来在庫見込みが月次で追えるようになります。

設計全体の流れ

今回の需給管理表は、以下の順序でPower Queryを組み立てると整理しやすくなります。

  1. Excelテーブル取り込み
  2. 月別データへの整形
  3. インデックス付与
  4. 累計営業目標需要
  5. 累計商談ベース需要
  6. 累計供給
  7. 営業目標ベース将来在庫
  8. 商談ベース将来在庫
  9. 不足数量・不足発生月の算出

「累計」はゴールではなく、将来在庫を算出するための中間計算と捉えると、需給管理表全体の構造が整理しやすくなります。

可視化:3段構成のグラフ

最終的な出力列(時期・集計対象・営業目標需要・商談ベース需要・供給・累計営業目標需要・累計商談ベース需要・累計供給・営業目標ベース将来在庫・商談ベース将来在庫)まで揃えると、次の3種類のグラフがきれいに作れます。

  • グラフ①:将来在庫見込(営業目標ベース/商談ベース)
  • グラフ②:累計需要・供給(累計営業目標需要/累計商談ベース需要/累計供給)
  • グラフ③:月別需要・供給(営業目標需要/商談ベース需要/供給)

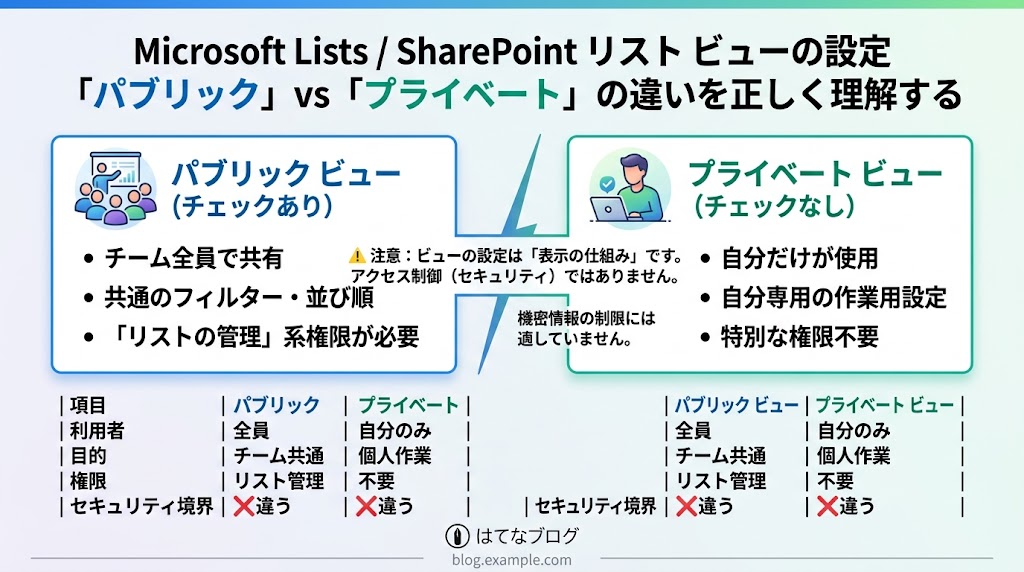
Microsoft Lists の「パブリック ビュー」とは?

Microsoft Lists や SharePoint リストでビューを作成する際に出てくる「パブリック ビュー」チェックボックス。何気なく使っている方も多いと思いますが、実はこの設定、「表示の仕組み」であって「セキュリティ境界」ではないという点を正しく理解していないと、社内説明資料などで誤解を招く表現になりがちです。

パブリック ビュー/プライベート ビューの挙動を整理し、社内ガイド用にそのまま使える形にまとめました。

パブリック ビューとプライベート ビューの基本

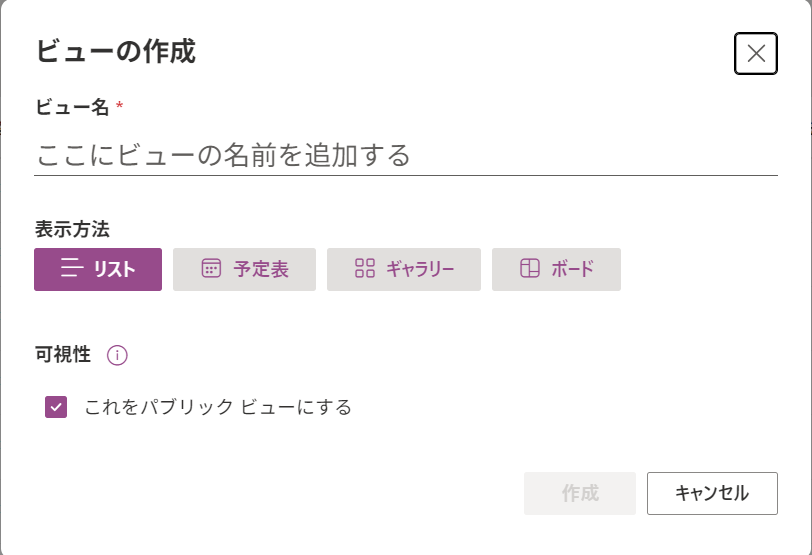
Microsoft Lists / SharePoint リストのビュー作成画面にある「パブリック ビュー」チェックボックスは、そのビューを誰が利用できるかを決める設定です。

  • パブリック ビュー(チェックあり) そのリストにアクセスできる全員が利用できる共通の表示形式。「進行中タスクのみ表示」「担当者別」など、チームで同じフィルターや並び順を共有したい場合に選択します。
  • プライベート ビュー(チェックなし) 自分だけが使用できるビュー。自分専用の作業用フィルターや並び順を設定したい場合、他人の表示画面に影響を与えたくない場合に選択します。

「パブリック」といっても、インターネット上に一般公開されるわけではなく、そのリストにアクセス権を持つ内部メンバーに見えるようになる、という意味である点は誤解されやすいので要注意です。

注意ポイント

注意ポイント① パブリック ビューを作れるのは権限がある人のみ

パブリック ビュー(共有ビュー)の作成・編集には、そのリストに対する「リストの管理」系の権限(デザイン、フルコントロール、または「パブリック ビューの管理」権限など)が必要です。

権限が低いメンバーの場合、ビュー作成時に「パブリックにする」チェックボックスが表示されない、またはグレーアウトして選択できないことがあります。この場合、作成できるのは原則としてプライベート ビューのみです。

つまり、パブリック/プライベートの切り替え自体が、ユーザーの権限によって選択肢に出るかどうかが変わります。

注意ポイント② ビューは「表示の仕組み」であり、アクセス制御の仕組みではない

  • パブリック ビューにしても、リスト自体のアクセス権がない人には表示されません。あくまで「そのリストを見られる人の中で、全員にこのビューを共有する」という意味です。
  • プライベート ビューであっても、その人がリストのアイテム自体へのアクセス権を持っていれば、別のビューや直接URLなどで同じデータにたどり着ける可能性があります。

ビュー=どう見せるかのレイヤーであり、データへのアクセス権そのものを制御する仕組みではないという点は、社内ガイドで特に強調すべきポイントです。機密項目を隠したい場合は、ビューのフィルターや列の非表示だけで完結させず、アイテムレベルの権限や列の機密設定など、アクセス制御の仕組みとセットで設計する必要があります。

また、パブリック ビューは「全員が利用できる」設定であり、「全員が編集できる」という意味ではありません。ビューの編集・削除ができるかどうかは、別途ユーザーの権限によって決まります。

社内ガイド用のおすすめ表現

社内向けの説明資料としてまとめるなら、以下の表現が推奨されます。

パブリック ビュー(チェックあり) そのリストへのアクセス権を持つ全員に共有されるビュー。チームで共通のフィルターや並び順を使いたい場合に選択。ただし、リスト自体の権限がない人には表示されない。ビューの編集・削除ができるかはユーザーの権限による。

プライベート ビュー(チェックなし) 作成者本人にしか表示されない個人用ビュー。自分専用の作業用フィルターや並び順を設定したい場合、または他人の表示に影響を与えたくない場合に選択。ただし、ビューは表示の仕組みであり、データ自体のアクセス権を制限するものではない。

まとめ:比較表

項目 パブリック ビュー プライベート ビュー
ビューの利用者 リストにアクセス権を持つ全ユーザー 作成者本人のみ
フィルター・並び順 チームで共通化できる 自分専用
他人の表示への影響 共通ビューなので影響あり 基本的に影響なし
データへのアクセス制御 しない しない
インターネット公開 しない しない
ビュー作成に必要な権限 「リストの管理」系権限が必要 特別な権限は不要
向いている用途 チーム共通の表示 個人の作業用表示

おわりに

「パブリック/プライベート」という言葉の響きから、ついアクセス権やセキュリティの設定と混同しがちですが、実際にはビューという表示レイヤーの共有範囲を決めているだけです。

社内で説明する際は、

  • 「ビュー=表示方法」
  • 「権限=データへのアクセス制御」

という2つを明確に切り分けて伝えると、誤解がぐっと減ります。また、パブリック ビューを作成できるかどうかは利用者の権限次第である点も、実務でつまずきやすいポイントなので合わせて押さえておくとよいでしょう。